
ただのLLMではない、 より優れた翻訳エンジン。
Opalは、企業の多言語コンテンツ用に構築されたAI翻訳エンジンです。ベンチマークでは、汎用機械翻訳、ニューラル機械翻訳、大規模言語モデル (LLM) よりも高い品質を示しました。また文節単位で、信憑性のある信頼度スコアがついています。さらに、APIファーストの設計のため、既存のワークフローにそのまま組み込めます。
パフォーマンス指標
総合信頼度

新規文字列
アクティブ
スループット
14,800リクエスト/分
レイテンシー
28ミリ秒
人によるレビュー
0.2%
本当の課題
貴社の翻訳基盤はスローペースな時代を前提にしていませんか?
昨今では、コンテンツの制作・更新スピードが従来のローカリゼーションプロセスの前提を上回っています。従来のプロセスでは、手動での引き渡し、バージョンのずれ、品質をめぐる主観的な議論が当たり前で、成長に直結するコンテンツタイプほど、単価が上昇傾向にあります。
翻訳管理システム (TMS) を入れ替えたり、同じワークフローの最初の段階にさらに大規模なLLMを導入したりしても、課題は解決できません。本質的な解決に必要となる最初の一手は、翻訳エンジンの刷新です。Opalは、実務レベルの多言語データで学習し、貴社のコンテンツに合わせて調整できる、翻訳特化型のAIです。また、主要な汎用LLMと比較したベンチマークを公開しています。Opalこそ、貴社のローカリゼーション運用が必要としている決め手なのです。
汎用LLM

ウェブからスクレイピングしたテキストで学習
品質水準は一律で、受け入れるか見送るかの二択
言語や分野を問わず汎用的
判断過程はブラックボックス
チャットインターフェースとして提供

数十年にわたる実務レベルの翻訳データで学習
すべての出力内容に対して文節単位の信頼度スコア
顧客ごと・コンテンツタイプごとに調整
監査に対応可能な出力、ベンチマークで実証された品質
APIとしてすでに運用中のシステムにそのまま組み込み可能
Opalの仕組み
汎用LLMではなく、
翻訳に特化したエンジン。
Opalは、多言語コンテンツ制作に特化し、実務レベル品質で学習を施したAIエンジンです。汎用モデルと異なる点は4つあります。

実務レベルの翻訳データで学習
実際に公開するコンテンツタイプにおいて、初期状態でも汎用LLMを上回る品質を発揮します。さらに、これまでのブランドトーンとの一貫性を維持できます。

コンテンツに合わせて調整
AIへのプロンプトを都度作り込む必要はありません。貴社独自のコンテンツで高品質を実現します。

文節単位の信頼度スコア
機械翻訳を合否判定で捉えるのではなく、チームが活用できるデータとして扱えるようになります。

APIファーストで、中立的なエコシステム
既存のシステムを変更・交換することなく、Opalを導入できます。
Opalが選ばれる理由
専用設計は、汎用設計に勝る。
第1位

文節
主張ではなく、公開ベンチマークで裏付けられた品質
Welocalize Opal Benchmark 1.0は、言語専門家によるブラインドレビューと複数名アノテーター体制を採用し、公開された評価手法に則って実施されました。その結果、Opalの出力は過半数の文節で1位となり、2位の機械翻訳とは19ポイントの差をつけました。
重要な理由:品質とは、誰かの言葉に頼るものではありません。評価手法とデータは文書で公開されていますので、ご自身で検証・比較できます。
リセットされず、蓄積されていく翻訳メモリ
翻訳メモリと用語集は、Opalの推論プロセスそのものに取り込まれ、訳文の生成段階から反映されます。最終工程での単純な一致検索・置換ではありません。そのため生成された出力は、これまでに貴社のチームが承認した用語や表現と整合性が取れたものになっています。
貴社にとってのメリット:実際に公開するコンテンツタイプにおいて、初期状態でも汎用LLMを上回る品質を発揮します。
推論
コンテキスト読み込み完了

翻訳メモリ
承認済み用語集
ブランドボイス
過去のコンテンツ
生成準備完了

裏付け
Opalの優位性は特定の言語や顧客に限った偶然ではない。
Opal Benchmark 1.0では、7つの企業アカウント、10の対象言語、5つのコンテンツ分野にわたり、5つの機械翻訳システムを評価しました。その結果の傾向は、すべてで一貫していました。
10 / 10
Opalが主要な汎用機械翻訳エンジンの評価を上回った対象言語の数
5 / 5
Opalがトップとなったコンテンツ分野の数 (製品、サポート、マーケティング、医療、サービス)
出典:Welocalize Opal Benchmark 1.0
信頼の裏付け:ベンチマークの評価手法
評価対象の翻訳エンジン名を隠した状態でアノテーションを行い、文節ごとに複数名の言語専門家がレビューしています。企業アカウントは7つにわたり、文節単位でスコアリングを行いました。評価手法と結果は公開されています。
測定方法を知らないまま、機械翻訳の品質を述べられても、ただ信じるしかありません。Opalのデータは検証可能です。
Opalは、Welo Globalが提供する幅広い企業向けローカリゼーションサービスの一部です。Welo Globalは、Forresterによるローカリゼーションサービスプロバイダーの独立評価『The Forrester Wave™: Localization Services, Q3 2026』でリーダー企業に選出されました。
導入方法
単語数に応じた従量課金、貴社のコンテンツに合わせた調整。
Opalは、処理した単語数に基づく従量課金制を採用しています。料金は、コンテンツ構成と分量に応じてお見積もりします。
導入に向けた最初の作業として、調整を行います。つまり本番稼働前に、貴社の用語、スタイル、既存の翻訳メモリに合わせてエンジンをカスタマイズします。すると、品質が複利のように高まっていきます。貴社のために稼働するOpalは、他社のためのOpalとは別物です。
OpalはWelocalizeから直接入手できるほか、PhraseやXTMなどのパートナープラットフォーム経由でもご利用いただけます。そのため、すでにお使いのツール内からOpalにアクセスできます。
どの段階からでも
エンジンは同じ、スタート地点はさまざま。
Opalは、企業規模のコンテンツ運用を対象として設計されています。また、小規模導入にも過不足なく対応します。
すでに成熟したローカリゼーションプロセスがある場合
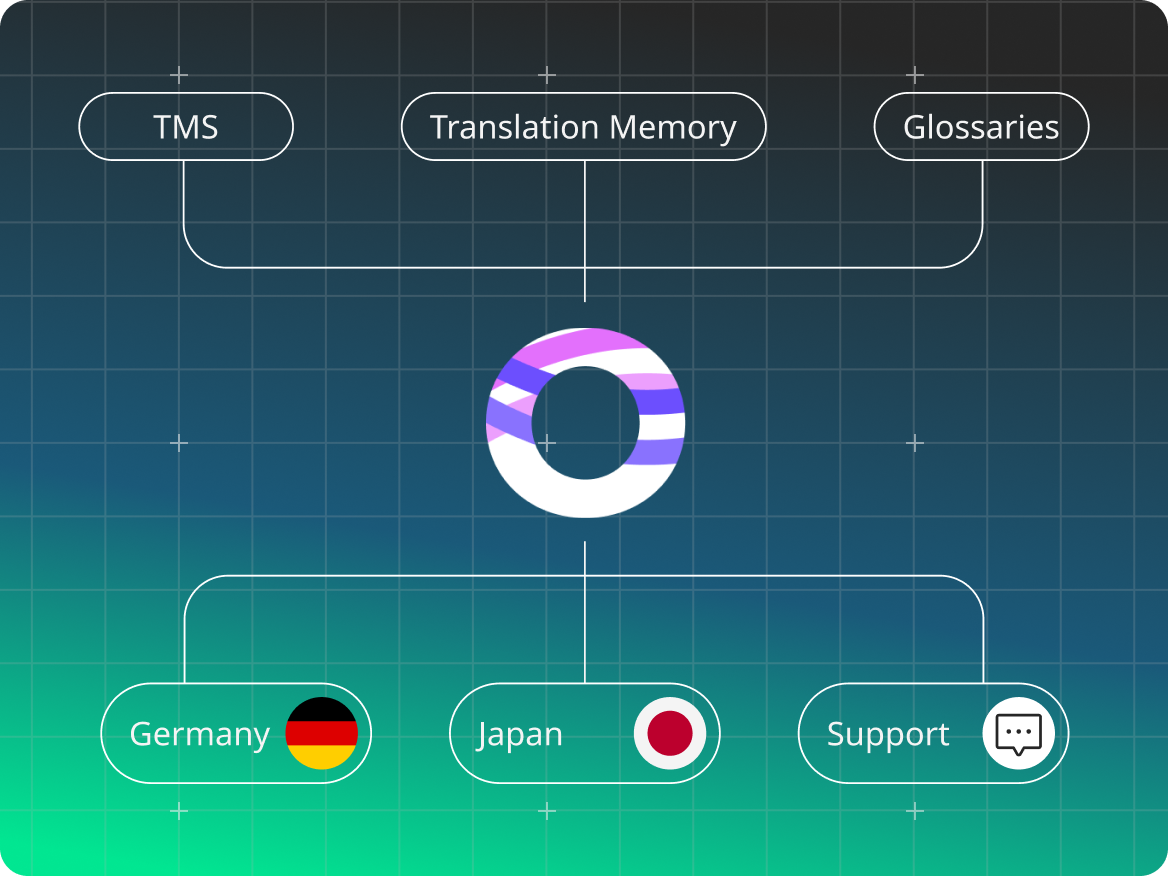
Opalは、既存のTMS、翻訳メモリ、用語集と併用できます。調整の際には、貴社がこれまでに構築した資産をすべて活用します。展開は市場単位やコンテンツタイプ単位で段階的に進められます。大掛かりな全面置換は不要です。
ローカリゼーションを初めて大規模展開する場合
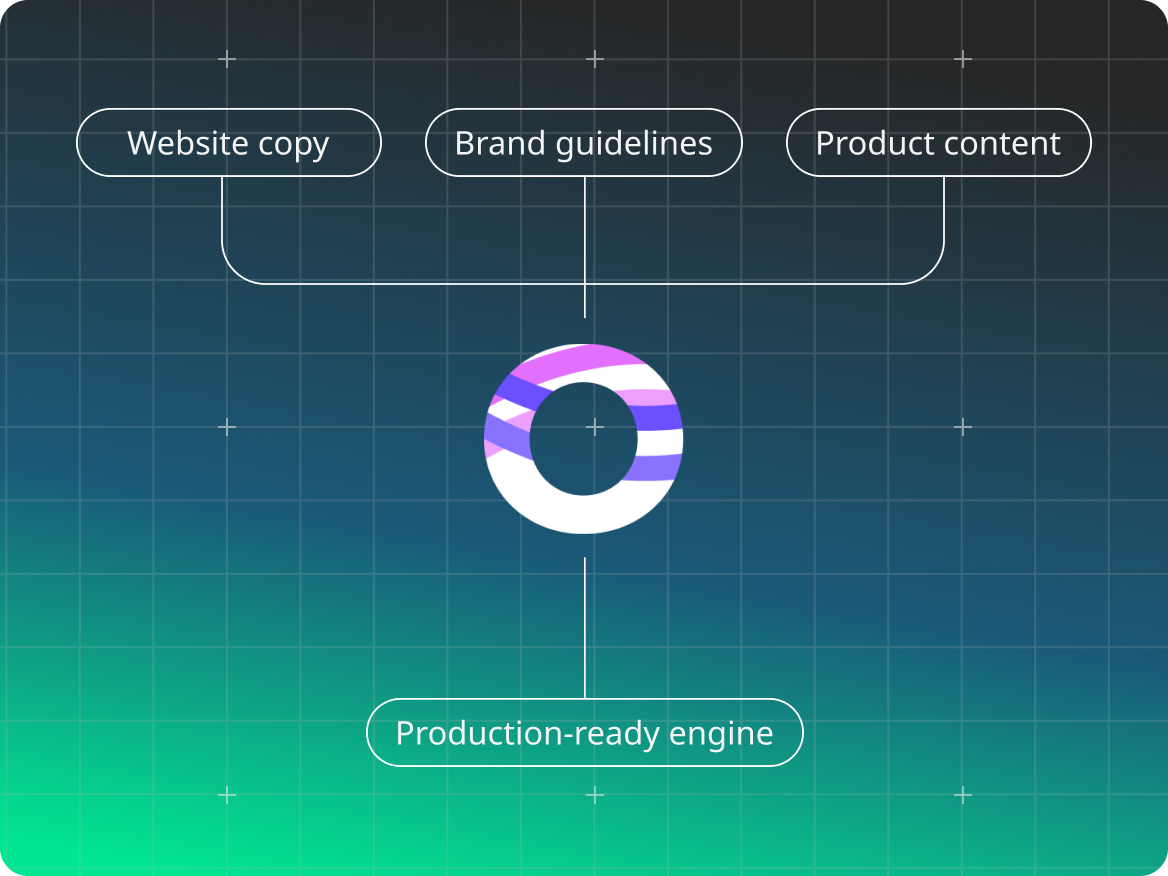
このような場合でも、お持ちの資産を活用し、貴社のコンテンツ・用語・トーンに合わせてOpalの調整を行います。実務レベルの品質水準に到達するために、10年分の翻訳メモリは必要ありません。
よくある質問
よくあるご質問にお答えします。
汎用LLMは、チャット向けに設計されたものです。実務レベルの多言語出力に向けて学習が施されておらず、貴社の用語・スタイル・翻訳メモリに合わせた調整もできません。Opal Benchmark 1.0において言語専門家によるブラインドレビューでは、Opalが全文節の57%で1位となり、次点の機械翻訳を19ポイント差で上回りました。汎用LLMは、むしろ成績が劣っていました。
Opalは単一の機械翻訳モデルではなく、エージェント型のシステムです。単発の出力ではなく、翻訳タスクに関わる複数の工程、品質チェック、意思決定ロジックを統合的に制御します。Opalは現在、本番環境で稼働しており、十数社の企業顧客においてAPI経由で利用されています。
いいえ、その必要はありません。OpalはAPI経由で呼び出されます。既存のTMSやCATツールを置き換えるのではなく、並行して動作します。さらに、既存のワークフローやシステムに適合するように設計されています。
既存の翻訳メモリは、これまでどおりそのままお使いいただけます。Opalは既存システムに追加する方式です。API経由で並行運用するため、既存の翻訳メモリ資産が置き換えられたり、利用できなくなったりすることはありません。
機械翻訳とは気づかない、最高水準の翻訳。
Opalは、既存のローカリゼーションプロセスの裏側で静かに稼働し、その品質水準を引き上げるAIエンジンです。デモをご予約いただければ、Opalが弊社のサンプルではなく、貴社のコンテンツで実際に動作する様子をご覧いただけます。